Amazonbot: když robot Amazonu srazí váš server na kolena
Na serverech, které spravujeme, se Amazonbot pravidelně objevuje v našich analýzách provozu, vedle dalších AI robotů, jako jsou GPTBot nebo meta-externalagent. Nejde o principiální postoj proti umělé inteligenci: pozorovali jsme ho při několika epizodách přetížení, kdy robot Amazonu vedl v záznamech přístupů, a to na webech, kterým nikdy nic nepřinesl.
Tento článek popisuje, co Amazonbot dělá, proč tolik zatěžuje e-shopy, jak ho najít v logech a jaké máte možnosti, jak ho zpomalit nebo zablokovat.
Co přesně je Amazonbot?
Amazonbot je univerzální webový crawler společnosti Amazon: podle své oficiální stránky slouží ke zlepšování produktů a služeb firmy a může být použit k trénování jejích AI modelů. Původně byl představován jako robot, který zásobuje daty Alexu, dnes je to jednoznačně sběrač trénovacích dat.
Amazon nyní rozlišuje tři agenty, z nichž každého lze v souboru robots.txt nastavit zvlášť:
| Agent | Deklarovaný účel | Trénování AI | Respektuje robots.txt |
|---|---|---|---|
| Amazonbot | Zlepšování produktů a služeb | Ano, je možné | Ano |
| Amzn-SearchBot | Vyhledávání (Alexa atd.) | Ne | Ano; bez vlastního pravidla se řídí pravidly pro ostatní vyhledávače |
| Amzn-User | Načtení v reálném čase pro odpověď uživateli | Ne | Ne vždy, protože akci spouští člověk |
User-agent vypadá jako běžný Chrome, za nímž následuje označení compatible; Amazonbot/0.1. Amazon zveřejňuje seznam IP adres každého agenta, takže lze skutečného robota odlišit od podvodníka.
Pro poskytovatele hostingu je velmi důležitý jeden detail: Amazonbot nepodporuje direktivu Crawl-delay. Nelze ho tedy jednoduše požádat, aby zpomalil. Respektuje však Disallow, rel=nofollow a meta značky noindex a noarchive, přičemž ta druhá u Amazonu znamená „nepoužívat stránku k trénování“. Projevení jakékoli změny v robots.txt může trvat zhruba 24 hodin a robot se může řídit kopií v mezipaměti starou až 30 dní.
Zjištěné problémy
Hlavní výtkou vůči Amazonbotu není to, že existuje, ale že přichází ve vlnách, bez varování a bez brzd. Nejsme jediní, kdo si toho všiml.
| Kdo | Kdy | Co se stalo |
|---|---|---|
| Xe Iaso, vývojářka | Leden 2025 | Její vlastní Git server se pod provozem připisovaným Amazonu stává nestabilním; nakonec napíše Anubis, filtr proti robotům založený na proof of work (Ars Technica) |
| git.gmem.ca | Červen 2024 | Zhruba 25 000 požadavků Amazonbotu zablokovaných za méně než 24 hodin na malé Git forge |
| Hypernode, hosting pro e-commerce | Květen 2023 | Několik serverů e-shopů, kde více než 10 % výpočetního výkonu spotřeboval Amazonbot; provoz se týden od týdne výrazně lišil |
| Fórum Discourse | 2021 | 39 649 požadavků Amazonbotu oproti 457 od dalšího návštěvníka; asi deset IP adres AWS, z nichž každá poslala za den přes 1 000 požadavků; autor nakonec podezírá podvodníka |
Tyto případy mají jedno společné: robot se zaměřuje na stránky, jejichž vygenerování je nejnáročnější. U Git forge jde o historii commitů a zobrazení blame. U e-shopu na WooCommerce nebo PrestaShopu jde o fasetové filtry: každá kombinace barvy, velikosti, ceny a značky vytváří samostatnou URL, tedy prakticky nekonečný počet stránek.
Robot, který bez omezení tempa sleduje všechny odkazy, pak prochází tisíce kombinací, které nikdo nikdy neotevře. Každá z nich obchází mezipaměť stránek, protože URL je jedinečná, a vyvolá požadavek na PHP a několik SQL dotazů.
Skutečný případ: Amazonbot uvězněný ve stránkování JetBlogu
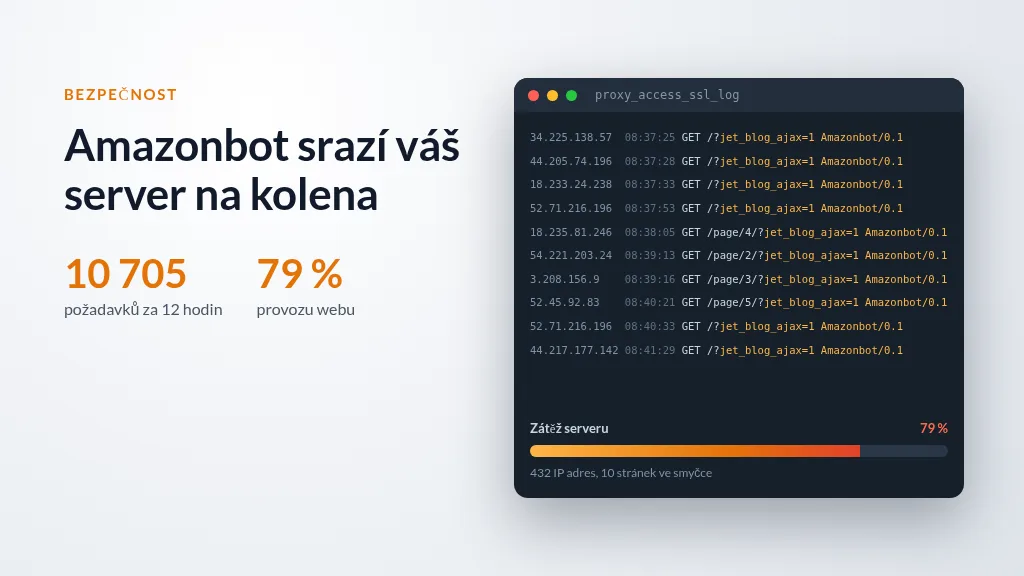
Začátkem října 2026 se Amazonbot na jednom WordPress webu, který hostujeme, točil v kruhu ve stránkování blogu. Za 12 hodin 5. října poslal 10 705 požadavků z 432 IP adres, tedy 79 % veškerého provozu webu. Kolotoč pokračoval i následující den; zde je zkrácený výňatek z přístupového logu ze 6. října (web není uveden a user-agent je zkrácen):
34.225.138.57  [06/Oct/2026:08:37:25] "GET /?jet_blog_ajax=1&nocache=1791224346&s"        200 32057 "-" "…Amazonbot/0.1…"
44.205.74.196  [06/Oct/2026:08:37:28] "GET /?jet_blog_ajax=1&nocache=1791228922&s"        200 32057 "-" "…Amazonbot/0.1…"
18.233.24.238  [06/Oct/2026:08:37:33] "GET /?jet_blog_ajax=1&nocache=1791120571&s"        200 32056 "-" "…Amazonbot/0.1…"
52.71.216.196  [06/Oct/2026:08:37:53] "GET /?jet_blog_ajax=1&nocache=1791224758&s"        200 32057 "-" "…Amazonbot/0.1…"
18.235.81.246  [06/Oct/2026:08:38:05] "GET /page/4/?jet_blog_ajax=1&nocache=1791241950&s" 200 31720 "-" "…Amazonbot/0.1…"
54.221.203.24  [06/Oct/2026:08:39:13] "GET /page/2/?jet_blog_ajax=1&nocache=1791241202&s" 200 31618 "-" "…Amazonbot/0.1…"
3.208.156.9    [06/Oct/2026:08:39:16] "GET /page/3/?jet_blog_ajax=1&nocache=1791240922&s" 200 31948 "-" "…Amazonbot/0.1…"
52.45.92.83    [06/Oct/2026:08:40:21] "GET /page/5/?jet_blog_ajax=1&nocache=1791241462&s" 200 30055 "-" "…Amazonbot/0.1…"
52.71.216.196  [06/Oct/2026:08:40:33] "GET /?jet_blog_ajax=1&nocache=1791213591&s"        200 32056 "-" "…Amazonbot/0.1…"
44.217.177.142 [06/Oct/2026:08:41:29] "GET /?jet_blog_ajax=1&nocache=1791126368&s" 200 32057 "-" "…Amazonbot/0.1…"Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Amazonbot/0.1; +https://developer.amazon.com/support/amazonbot) Chrome/119.0.6045.214 Safari/537.36| Měření (5. října, 8:00 až 20:00) | Hodnota |
|---|---|
| Požadavky Amazonbotu | 10 705, tedy v průměru jeden každé 4 sekundy |
| Podíl na celkovém provozu webu | 79 % (10 705 z 13 611 požadavků) |
| Z toho stránkování JetBlogu | 100 % |
| Pravidelnost | Mezi 887 a 896 požadavky každou hodinu, nejvýše 16 za minutu |
| Různé IP adresy | 432; nejaktivnější poslala za 12 hodin jen 52 požadavků |
| Skutečně odlišné stránky | 10: úvodní stránka a stránky 2 až 5 blogu, stránka Reference a její stránky 2 až 4, jedna prezentační stránka |
| Odpovědi | 100 % HTTP 200 |
| Přenesený objem | 323,6 MB, tedy přibližně 30 kB na požadavek |
| Projekce na 24 hodin při tomto tempu | Zhruba 21 000 požadavků a 650 MB |
| IP ověřené v oficiálním seznamu Amazonbotu | 58 z 58 ve výňatku ze 6. října (seznam z 8. září 2026) |
Co tento výňatek ukazuje
Je to opravdu Amazonbot, ne podvodník. Všechny IP adresy z výňatku jsou v seznamu zveřejněném Amazonem. Oficiální robot nadnárodní společnosti tedy dokáže sám vytvořit takový provoz.
Robot padl do pasti nekonečných URL. Modul JetBlog (sada Crocoblock pro Elementor) načítá své stránkování přes AJAX. Jeho odkazy obsahují jet_blog_ajax=1 a parametr nocache, který se při každém zobrazení mění. Pro robota je každá hodnota novou stránkou: donekonečna znovu žádá stejných deset stránek pod různými názvy, pravidelně jako metronom. Hodnoty nocache navíc vypadají jako časová razítka z předchozích dnů, což naznačuje, že robot znovu přehrává odkazy nasbírané při dřívějších návštěvách.
Mezipaměť je k ničemu. Protože je každá URL jedinečná, žádná odpověď se nedoručí z mezipaměti: všech 10 705 požadavků za 12 hodin zpracovaly PHP a MySQL, jen aby stále dokola vracely stejných deset stránek.
Blokování podle IP je zbytečné. Při 432 adresách za 12 hodin poslala nejaktivnější IP jen 52 požadavků, sotva něco přes 4 za hodinu. Fail2ban ani limit požadavků na IP nevidí nic neobvyklého; reagovat lze jen podle podpisu požadavku, tedy user-agentu nebo tvaru URL.
Co jsme zavedli
Místo blokování Amazonbotu jsme odstranili příčinu: pravidlo na úrovni aplikačního firewallu zneškodní tuto past pro všechny roboty. Stránkování JetBlogu vyžádané bez AJAX hlavičky X-Requested-With, což žádný prohlížeč nedělá, se přesměruje kódem 301 na čistou URL. Robot se tak vrací na jedinou adresu, kterou obsluhuje mezipaměť.
Proč je to pro poskytovatele hostingu tak nákladné
Na sdíleném serveru robot, který se na jednom webu utrhne ze řetězu, zpomaluje všechny ostatní. Procesy PHP, připojení k MySQL a paměť jsou sdílené: několik tisíc fasetových stránek vygenerovaných za hodinu stačí k tomu, aby se prodloužila doba odezvy desítek webů, které o nic nežádaly.
Případ Amazonbotu zhoršují tři faktory:
- Žádný
Crawl-delay. Jediné standardní nastavení, jak požádat o zpomalení, je ignorováno. Zbývá jen prostý zákaz, částečný nebo úplný. - Pouze dynamické stránky. Crawler nestahuje obrázky, CSS ani JavaScript; žádá jen HTML, tedy tu nejdražší část.
- Nic na oplátku. Na rozdíl od Googlebotu nebo Bingbotu nepřivádí Amazonbot typickému evropskému e-shopu žádné měřitelné návštěvníky. Náklady na server jsou skutečné, přínos zůstává hypotetický.
Právě tato nerovnováha, víc než samotný objem, ospravedlňuje to, abychom ho řešili odděleně od klasických vyhledávačů.
Jak ho najít v logech
Amazonbot se poctivě hlásí svým user-agentem: pro první měření stačí jednoduché vyhledání slova Amazonbot v přístupových logech. Na serveru s Pleskem jsou logy v /var/www/vhosts/system/<doména>/logs/; pokud nginx slouží jako proxy před Apachem, čtěte soubory proxy_access*.
Weby, které Amazonbot navštěvuje nejvíc:
for d in /var/www/vhosts/system/*/; do
  n=$(cat "$d"logs/*access_ssl_log 2>/dev/null | grep -c Amazonbot)
  [ "$n" -gt 0 ] && echo "$n $(basename "$d")"
done | sort -rn | head
Tempo po hodinách na jednom webu, abyste odhalili vlny:
grep Amazonbot /var/www/vhosts/system/example.com/logs/proxy_access_ssl_log \
  | awk '{print substr($4, 2, 14) "h"}' | uniq -c | tail -24
Skutečný robot, nebo podvodník?
Kdokoli může do user-agentu napsat „Amazonbot“ a mnoho škodlivých robotů běží na pronajatých serverech AWS, tedy s IP adresami patřícími Amazonu. IP adresa „od Amazonu“ nic nedokazuje: případ Discourse z roku 2021 pocházel z IP adres EC2 a jeho autor dospěl k závěru, že šlo o podvodníka.
Dvě spolehlivá ověření:
- Porovnat IP adresu se seznamem zveřejněným Amazonem.
- Provést reverzní DNS dotaz: skutečný robot odpoví názvem v doméně
crawl.amazonbot.amazon, který pak potvrdíte přímým dotazem.
host <podezřelá IP>         # musí vrátit ...crawl.amazonbot.amazon
host <vrácený název>        # musí vrátit stejnou IP
Toto rozlišení je důležité: podvodník robots.txt ignoruje a zastaví ho jen blokování na straně serveru.
Opatření, od nejmírnějšího po nejráznější
1. Soubor robots.txt, web po webu
To je zdvořilá metoda a Amazon se zavazuje ji u Amazonbotu respektovat. Chrání jen před skutečným robotem a začne platit až za 24 hodin.
Zakázat celý web:
User-agent: Amazonbot
Disallow: /
Nebo jen fasety, přičemž stránky produktů zůstanou přístupné:
User-agent: Amazonbot
Disallow: /*?*filter_
Disallow: /*?*pa_
Disallow: /*?*min_price=
Disallow: /*?*q=
Chcete-li odmítnout použití svých textů k trénování, aniž byste blokovali procházení, Amazon rozpoznává také značku <meta name="robots" content="noarchive">.
2. ModSecurity, na úrovni serveru
Soubor robots.txt platí jen pro roboty, kteří ho respektují, a mění se web po webu. Aplikační firewall ModSecurity zasahuje dříve: odmítne požadavek podle jeho user-agentu nebo tvaru URL ještě předtím, než se zapojí WordPress nebo PrestaShop. Požadavek zablokovaný v této fázi server nestojí téměř nic a zastaveni jsou i podvodníci, kteří se vydávají za Amazonbot.
Na serveru s Pleskem lze toto nastavení použít doménu po doméně, abyste ochránili konkrétní web, aniž byste zasahovali do ostatních, nebo globálně pro všechny hostované weby. Správná úroveň závisí na vašich webech a jejich provozu: proberte to s naším technickým týmem, který pak v logech ověří, že nastavení má očekávaný účinek.
3. Pozor na svůj kód: žádné černé díry pro roboty
Případ JetBlogu to ukazuje: problém nezpůsobil jen robot, ale i modul, který donekonečna vyráběl URL. Pro crawler je každý nový odkaz novou stránkou k návštěvě. Web, který je generuje bez konce, se stává černou dírou, která ho vtáhne, a každý průchod se platí serverovými prostředky.
Nejčastější zdroje černých děr:
- parametry proti mezipaměti nebo s časovým razítkem přidávané do odkazů, jako
nocacheve stránkování AJAX JetBlogu; - fasetové filtry WooCommerce nebo PrestaShopu, jejichž kombinace jdou do tisíců;
- kalendáře a archivy, ve kterých lze donekonečna postupovat měsíc po měsíci;
- stránky interního vyhledávání dostupné přes odkaz, a to i s prázdným vyhledáváním (
?s=).
Často stačí pár návyků: podívat se v logech, které URL roboti skutečně navštěvují, nezveřejňovat jako běžné odkazy adresy určené jen pro AJAX, označit tyto odkazy rel="nofollow", který Amazonbot respektuje, a zakázat jejich vzory v robots.txt:
User-agent: *
Disallow: /*jet_blog_ajax=
Disallow: /*?*filter_
V našem případě, protože šlo o skutečný Amazonbot, by stačil první z těchto řádků, aby stránkování JetBlogu opustil, a to se zpožděním zhruba 24 hodin, které Amazon uvádí.
Blokovat, nebo ne?
Zablokování Amazonbotu nemá žádný vliv na pozice v Googlu ani v Bingu, takže je to pro většinu webů rozhodnutí s nízkým rizikem. Přesto existují argumenty pro obě strany.
| Blokovat | Nechat projít |
|---|---|
| Nižší zatížení serveru, zejména u e-shopů s fasetami | Možná viditelnost v odpovědích Alexy a AI služeb Amazonu |
| Obsah se nepoužije k trénování modelů | Program Amazon Content Partners: malý bonus k affiliate provizi a kredity na hosting pro weby, které ho povolí |
| Žádná měřitelná ztráta provozu pro typický evropský web | Blokování podle user-agentu nezastaví podvodníky, kteří stejně vyžadují jinou obranu |
Pro affiliate web Amazonu nebo médium, které cílí na hlasové vyhledávání, je dobrým kompromisem částečné blokování omezené na fasety a stránky vyhledávání. Pro e-shop hostovaný na sdíleném serveru zůstává úplné zablokování nejjednodušší volbou.
Shrnutí
Amazonbot není hacker: ohlašuje se, zveřejňuje své IP adresy a respektuje robots.txt. Neumí ale zpomalit, míří na nejdražší stránky a webům, které navštěvuje, nepřináší téměř nic. Nejprve změřte jeho podíl ve svých logech, ověřte, že jde opravdu o něj, a pak se rozhodněte mezi cíleným robots.txt a blokováním na serveru. A ať zvolíte cokoli, chraňte své fasety: příští robot nemusí být tak zdvořilý.
V HaiSoft sledujeme provoz webů, které hostujeme, a serverů, které spravujeme. Zatěžuje váš web nějaký robot, nebo si nejste jisti, jaké opatření zvolit? Kontaktujte náš technický tým.
Zdroje
- Amazon Developer: About Amazonbot
- Amazon Developer: seznam IP adres Amazonbotu
- Xe Iaso: Amazon's AI crawler is making my git server unstable
- Ars Technica, přes Harvard TagTeam: Devs say AI crawlers dominate traffic
- Hypernode: How Amazon's web crawler could impact the performance of your online store
- Discourse Meta: Amazonbot abusive crawling
- SegmentFault: shrnutí příspěvku z git.gmem.ca